硬件选型与显存评估
由于 DeepSeek 采用了多头潜在注意力(MLA)以及稀疏混合专家(MoE)创新机制,在激活参数仅为 37B 的情况下可提供超越传统密集模型的顶级推理表现。开发者可根据自身硬件算力选择相应点簇密度的部署规格:
| 模型版本规格 |
最少显存需求 |
推荐显卡配置 |
适用场景与推理表现 |
| DeepSeek-R1-Distill-7B |
8 GB VRAM |
RTX 3060 / 4060 / M1 Mac |
轻量本地部署、离线个人助手、边缘开发调试 |
| DeepSeek-R1-Distill-14B |
16 GB VRAM |
RTX 4070Ti / RTX 4080 (16G) |
中度数理推理、复杂 Python/Go 编码工程 |
| DeepSeek-R1-Distill-32B |
24 GB VRAM |
RTX 3090 / 4090 (24G) |
顶尖推理入门、消费级卡运行深度反思思维链 |
| DeepSeek-R1-Distill-70B |
48 GB VRAM |
2× RTX 3090 / RTX 6000 Ada |
企业私有化知识库、复杂科研论文推演 |
| DeepSeek-R1 满血版 671B |
320 GB+ VRAM |
4× H800 / 8× A100 (80G) |
全局最高推理质量、全功能 MoE 稀疏激活 |
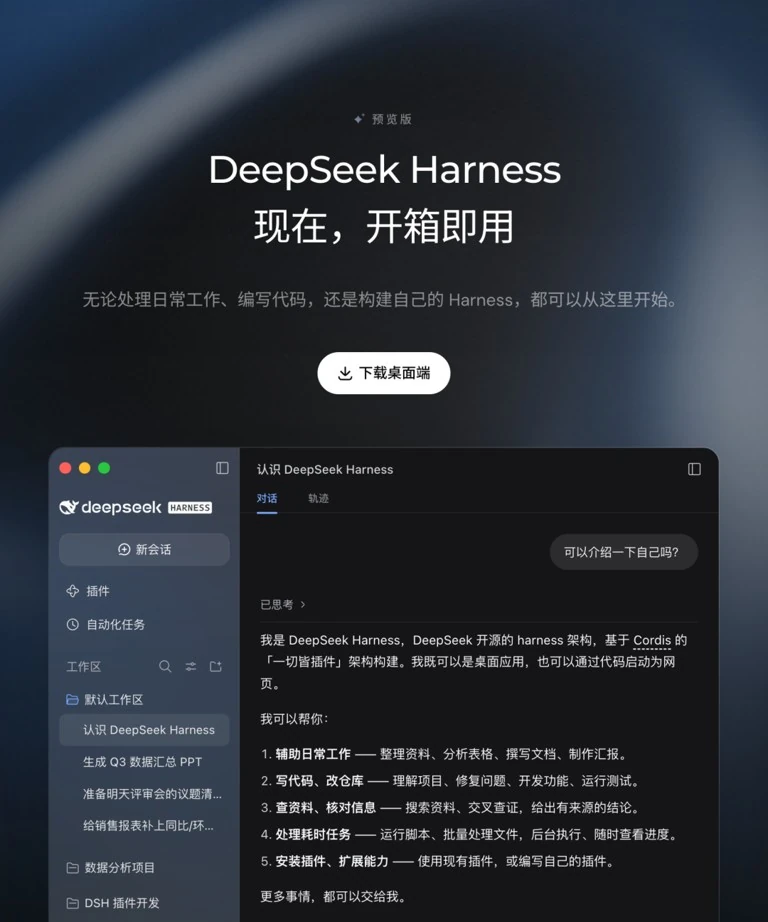 图 1 · 点云端点多卡互联拓扑 · InfiniBand 网络下多节点张量并行与管道并行示意
Ollama 本地单机 3 分钟极速运行
借助 Ollama 工具,无需配置 Python 依赖,一行指令即可自动拉取量化点云权重并在本地终端或 GUI 中建立安全隔离的推理实例。
步骤 1:下载并初始化 Ollama
通过终端确认已安装 Ollama 守护进程,并在前台或服务中保持运行:
# 验证 Ollama 运行状态
ollama --version
步骤 2:拉取指定蒸馏版本推理模型
按显存容量按需拉取蒸馏满血点云权重:
# 针对 16G 显存推荐运行 14B 蒸馏版
ollama run deepseek-r1:14b
# 针对 24G 显存(如单张 4090)推荐运行 32B 版
ollama run deepseek-r1:32b
步骤 3:与本地模型交互并观察思维链
输入数学竞赛题目或算法优化需求,模型将先输出带有 <think> ... </think> 标签的深度反思全过程,随后输出最终结论与代码。
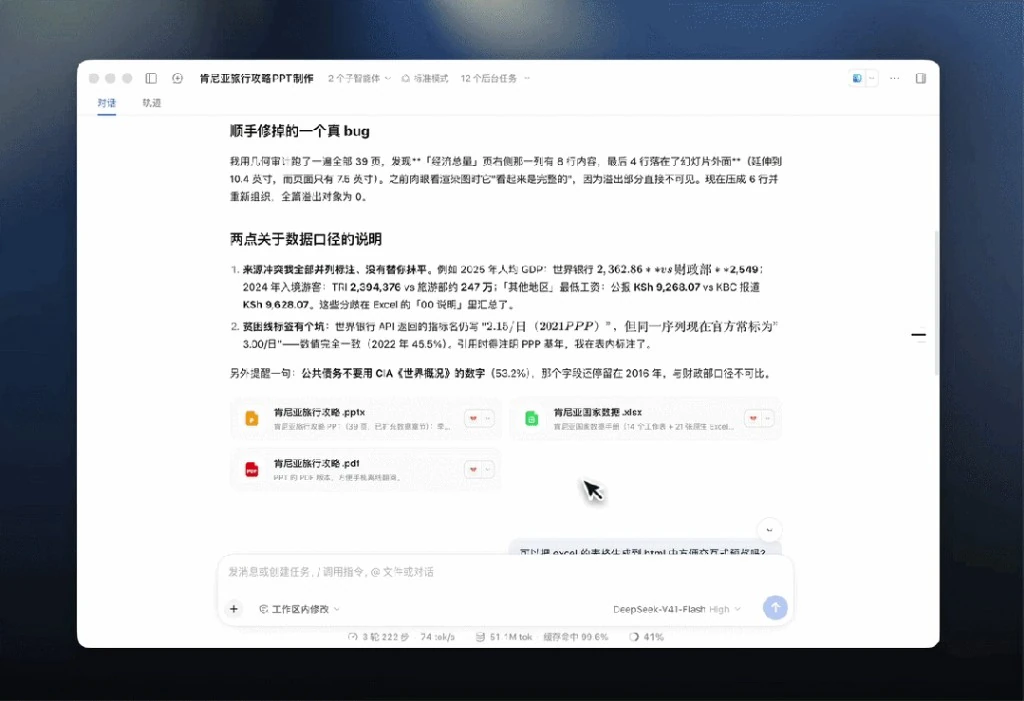 图 2 · 本地终端运行 · Ollama 纯离线环境下实时输出点云思维链
vLLM 多卡生产级吞吐加速
在企业高并发与私有云部署场景中,推荐使用 vLLM 搭配 PagedAttention 与 FP8/BF16 混合精度,榨干 GPU 显存带宽,支持数千并发连接。
# 启动 4 卡张量并行(Tensor Parallelism = 4)
vllm serve deepseek-ai/DeepSeek-R1-Distill-Qwen-32B \
--tensor-parallel-size 4 \
--max-model-len 32768 \
--gpu-memory-utilization 0.92 \
--enforce-eager \
--port 8000
启动后,vLLM 会在 http://localhost:8000/v1 暴露与 OpenAI 官方完全兼容的 HTTP 接口,可无缝对接 LangChain、LlamaIndex、OpenWebUI 及各类知识库插件。
 图 3 · 生产级监控 · vLLM 高并发流水线 PagedAttention 显存优化曲线
DeepSeek api开放平台与 Context Caching
DeepSeek 官方 API 拥有行业标杆级别的性价比。引入三维点云空间前缀重用机制,若系统提示词(System Prompt)或多轮长对话历史被重复命中,输入费用可下调高达 80%:
- 常规输入价格:1.00 元 / 百万 Tokens
- 缓存命中输入价格:0.10 元 / 百万 Tokens(节省 90%)
- 输出价格(含完整思维链):2.00 元 / 百万 Tokens
Python 最短可运行调用示例
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ.get("DEEPSEEK_API_KEY", "sk-your-key"),
base_url="https://api.deepseek.com"
)
# 开启 reasoning_content 获取长思维链
response = client.chat.completions.create(
model="deepseek-reasoner",
messages=[
{"role": "user", "content": "证明:对于任意正整数 n,2^(2^n) + 1 的末位数字都是 7 (n >= 2)。"}
],
stream=False
)
# 提取深度思考链路与最终答案
print("【思维链】:", response.choices[0].message.reasoning_content)
print("【最终结论】:", response.choices[0].message.content)
DeepSeek Harness 自动化沙箱评测
DeepSeek Harness 是一套专为长思维链大模型设计的标准化安全沙箱自动化评测套件,覆盖 Codeforces、AIME 数学竞赛、SWE-bench 真实 GitHub issue 修复等严苛基准。
# 克隆并初始化 Harness 沙箱评测套件
git clone https://github.com/deepseek-ai/DeepSeek-Harness.git
cd DeepSeek-Harness && pip install -e .
# 对本地 vLLM 实例启动 AIME 2024 数学基准评测
python evaluate.py \
--model-url http://localhost:8000/v1 \
--task aime_2024 \
--sandbox-timeout 30 \
--num-samples 16 \
--output-dir ./results/r1_benchmark
 图 4 · Harness 自动化沙箱 · 隔离环境内自动化测试用例验证与成功率汇总图表
常见疑难 FAQ
这是纯强化学习模型的典型特征。模型在思考区(reasoning_content)尝试了大量的反例、枚举与中间推导,排除了所有逻辑陷阱,因此最终回答区仅精炼直击命题核心结论。
当您的并发请求数超过当前用户组或未充值测试配额时会返回 429。建议在客户端请求头中加入带有指数退避(Exponential Backoff)的重试逻辑,并在 api开放平台后台配置合适的速率上限。
完全允许。DeepSeek-R1 及其全部蒸馏系列均采用宽松的 MIT 开源许可证,允许免费用于商业运营、私有云部署及衍生模型二次微调训练,无任何恶意闭源限制。